X Digest
XまとめAlibaba Qwen3.8-Omni-Flash、音声・映像を一つのモデルで処理
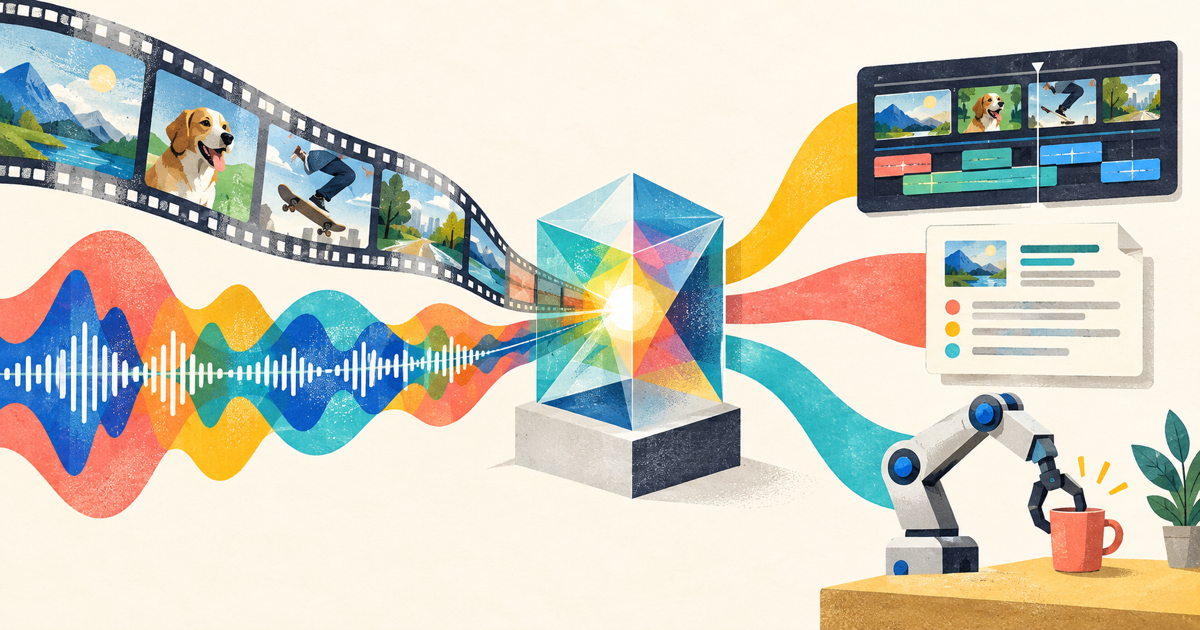
複数のX投稿が、AlibabaのQwenチームによるQwen3.8-Omni-Flashの公開を伝えた。テキスト、画像、音声、動画を一つのリクエストで扱い、100万トークンのコンテキストを備えるという。動画や会議録を扱う人にとって重要なのは、入力形式が増えたことより、長い素材を理解して道具を動かすところまで一つの流れにしようとしている点だ。
「見る・聞く」から作業を進めるモデルへ
Eugenio Fierro氏の紹介では、最長1時間の連続した音声・映像を一度に処理でき、Vlogの自動編集、短い動画の翻訳、映画の要約などが想定されている。会議なら、映像と複数人の声を別々の仕組みに渡すのではなく、同じ入力として読み、要約や次の作業へつなぐイメージだ。
一方、Qwen2.5-Omniと違い、Qwen3.8-Omni-Flashの応答はテキストのみとされる。「聞いて見られる」ことと、音声で話せることは別だ。Qwen-MM-PluginsとQwen-Live Harnessも公開されると同氏は伝えており、狙いはメディア理解そのものより、コーディングエージェントが画像・音声・動画を材料に道具を使う環境にあるように見える。
価格差は大きいが、比較の物差しがそろっていない
価格面では大幅な低下が強調された。ただし、投稿間で比較対象が異なる。Fierro氏はQwen側の説明として、旧モデルQwen3.5-Omni-Plus比で音声入力が98%超、音声・映像入力が93%超下がったと紹介した。Lomash Kumar氏はGemini 3.8 Flashとの比較を検討対象にし、別のまとめ投稿には動画コスト89%減との記載もある。数字だけを横並びにするのは危険だ。
導入を考えるなら、見るべき点は次の三つだろう。
- 自分の素材で、前処理を一つにまとめられるか
- 1時間あたりの実費と、誤認識を直す手間を合わせて得か
- テキスト出力とホスト型APIという提供条件で、用途を満たせるか
今回の数値やベンチマークは投稿者が伝えるQwen側の主張が中心で、独立した比較結果ではない。
「Qwen3.8」の名前だけでローカルモデルと判断しない
Kumar氏は、Qwen3.8-Omni-Flashと別のオープンウェイトモデルQwen3.8-Flash-Nextが混同されていると指摘した。Omni-Flashについては、開始時点でオープンウェイトの発表はなく、ホスト型APIで提供されるとの紹介だ。Mike T.氏の業界まとめには、さらにQwen3.8-27Bを基にしたTernary Bonsai 2 27Bも登場する。同じQwen3.8という名前が見えても、入力形式、配布方法、ローカル実行の可否は別々に確認したい。
この5件から見えるのは、マルチモーダル競争が「何を認識できるか」から「長い実データを、いくらで次の作業へ渡せるか」へ移っていることだ。派手な削減率より、手元の1時間の素材がどこまで一度で片づくか。そこが実用上の分かれ目になる。