X Digest
XまとめQwen3.8 27B、5.9GB圧縮と2枚eGPUでローカル実行の幅が広がる
Qwen3.8 27Bを手元で動かす選択肢が、二つの方向で広がっている。Xでは、モデルを5.9GBまで圧縮する試みと、16GB級GPUを2枚つないで使えるメモリを増やす実測が相次いだ。高価な単体GPUだけでなく、「小さくする」「手持ちを足す」という現実的な道が見えてきた。
5.9GBに縮める道
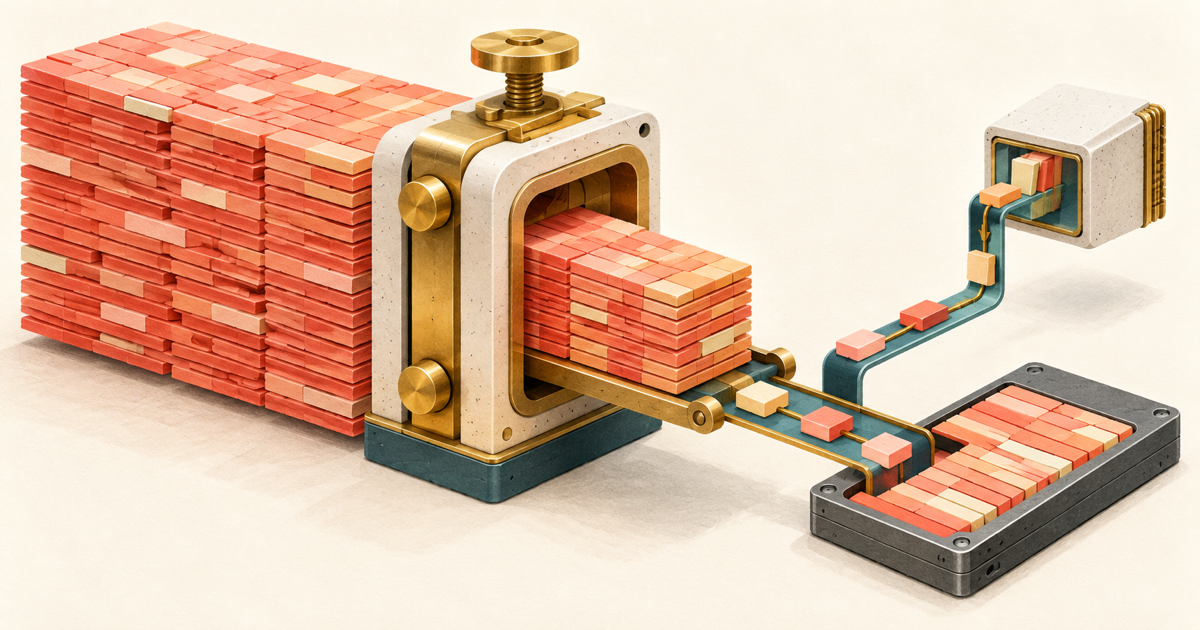
AI Native Guy氏が引用したPrismMLの発表文によると、Ternary Bonsai 2 27BはQwen3.8 27Bを基に、フル精度版の9分の1となる5.9GBまで縮小したモデルだ。総合ベンチマーク性能の98.2%を維持し、Apache 2.0で提供するとしている。前版から容量は変えず、エージェント型コーディング、マルチモーダル推論、長時間のツール利用で改善したという。
ただし、これらは発表側の集計値を紹介した投稿で、独立検証の結果ではない。5.9GBなら保存やメモリの壁は大きく下がるが、それだけで手元のノートPCにおける速度や品質まで決まるわけではない。
2枚のGPUを束ねる道
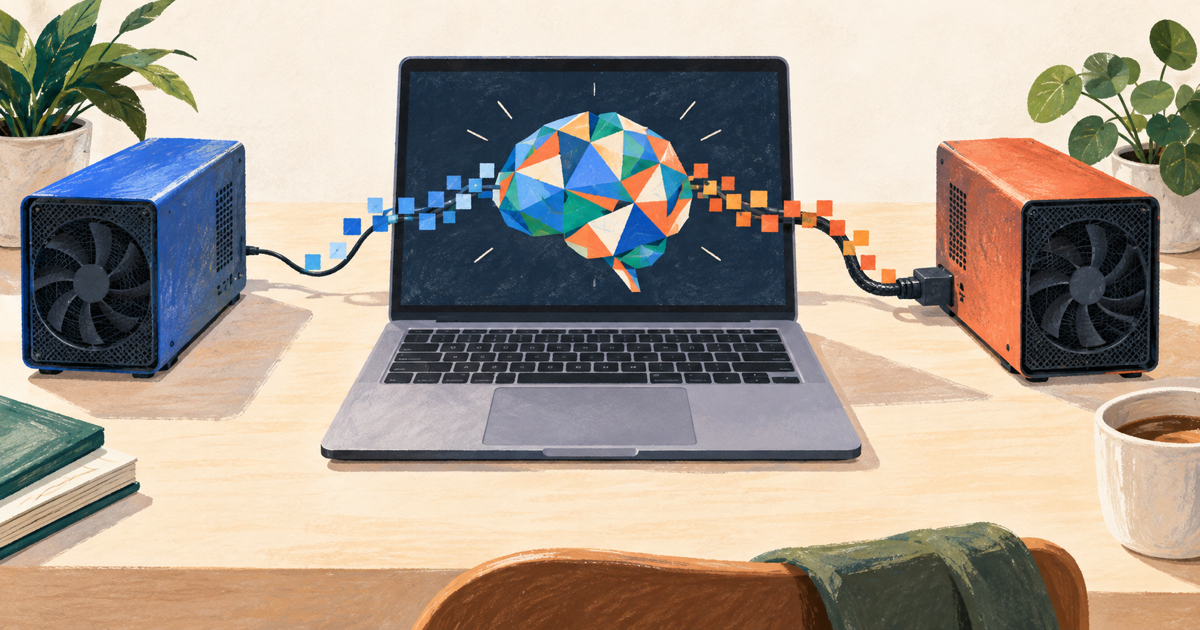
もう一つは、モデルを強く圧縮せず、複数のGPUへ分ける方法だ。もみじ氏は、OCuLinkとUSB4で外付けGPUを2枚接続し、LM StudioでTensor Parallelismを使った結果を報告した。1枚時の63.66トークン毎秒から82.01トークン毎秒へ、約1.29倍の向上だ。理論値として挙げた1.8倍には届かないが、この構成ではUSB4接続も利用価値があった、という本人の観察である。
同氏によれば、Qwen3.8 27Bは16GBでは強い量子化が必要になる一方、32GBならQ6〜Q8を動かせるという。これは一般的な保証ではなく、構成と形式を伴う実測として読むべきだ。それでも「32GBの単体GPUを買う」以外に、16GB級を2枚使う案を具体的に比較できる材料にはなる。
速さの数字より、条件をそろえる
Mike T.氏の業界まとめも、Apple Siliconで144トークン毎秒、2枚の3090での遅延短縮、大型MoEモデルのMac実行など、Qwen3.8周辺の報告が増えていると整理した。ただし、モデルの種類、圧縮形式、機器が違う数字は横並びにできない。
選ぶときは、まず「必要な品質でメモリに収まるか」を見る。次に、同じ量子化形式と機器で速度を確かめる。最後に、その結果が発表元のベンチマークか、個人の実測か、複数事例のまとめかを分ける。ローカルAIの選択肢は確かに増えたが、近道は最速の数字を探すことではなく、自分の機材で再現できる条件を見つけることだ。