Editor’s Note
XピックアップQwen、長時間エージェント訓練基盤「QwenGyre」を発表 GPU配分を実行中に切り替え
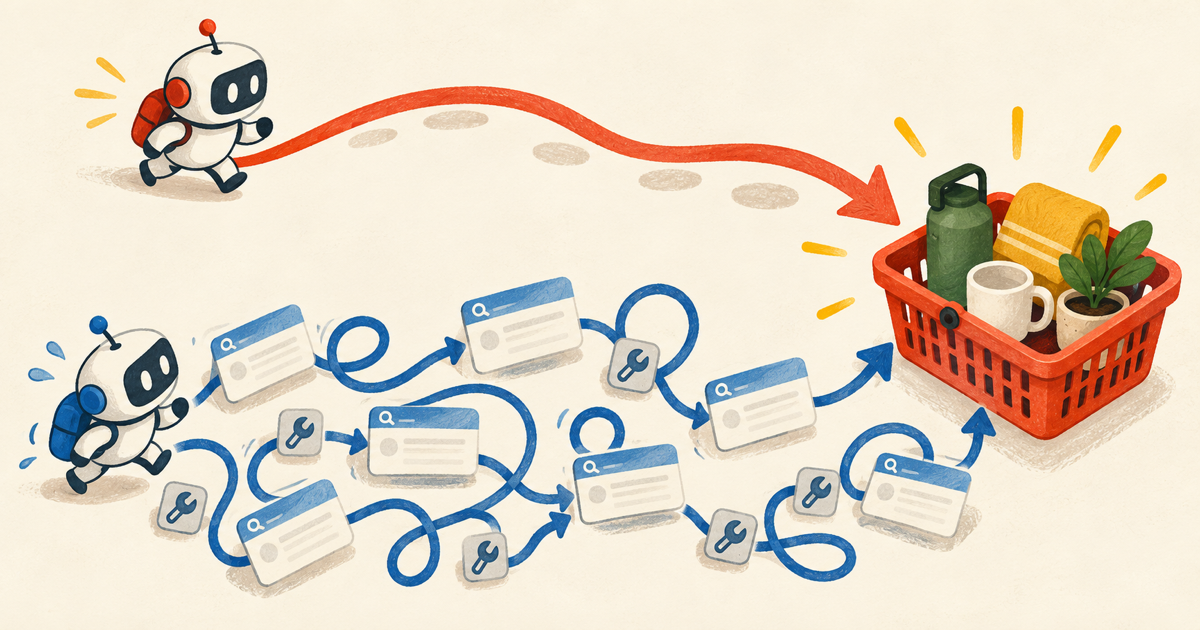
Qwenは10月12日、長時間動くAIエージェントを強化学習で鍛える基盤「QwenGyre」を紹介した。これは新しいモデルやエージェントではない。数時間続く分岐型の実行を止めず、空いたGPUを訓練へ回し、重複する作業履歴を減らす仕組みだ。長いエージェント実行では、賢さだけでなく「待っている計算資源をどう減らすか」が訓練時間を左右する。
実行を止めずに、GPUの役割を変える
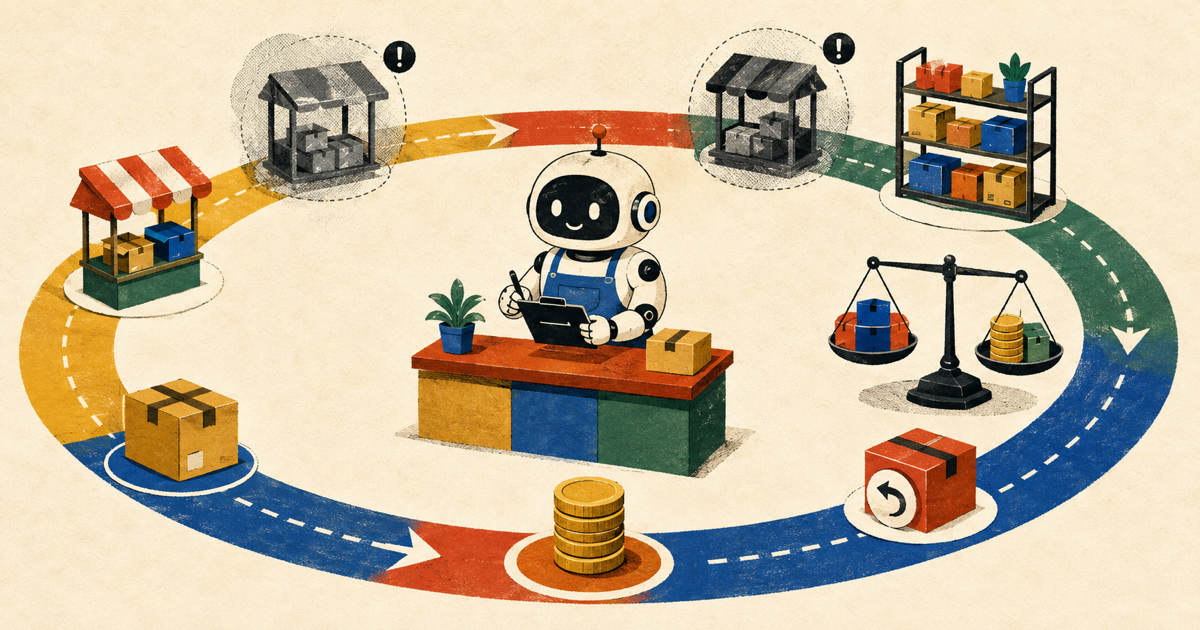
論文が比べる従来方式は二つある。AsyncはGPUを実行用と訓練用に固定分割し、Colocateは共有プール全体を二つの仕事へ交互に切り替える。QwenGyreはクラスタを独立した「セル」に分け、完了データで訓練を始めながら、残りのセルではエージェント実行を続ける。
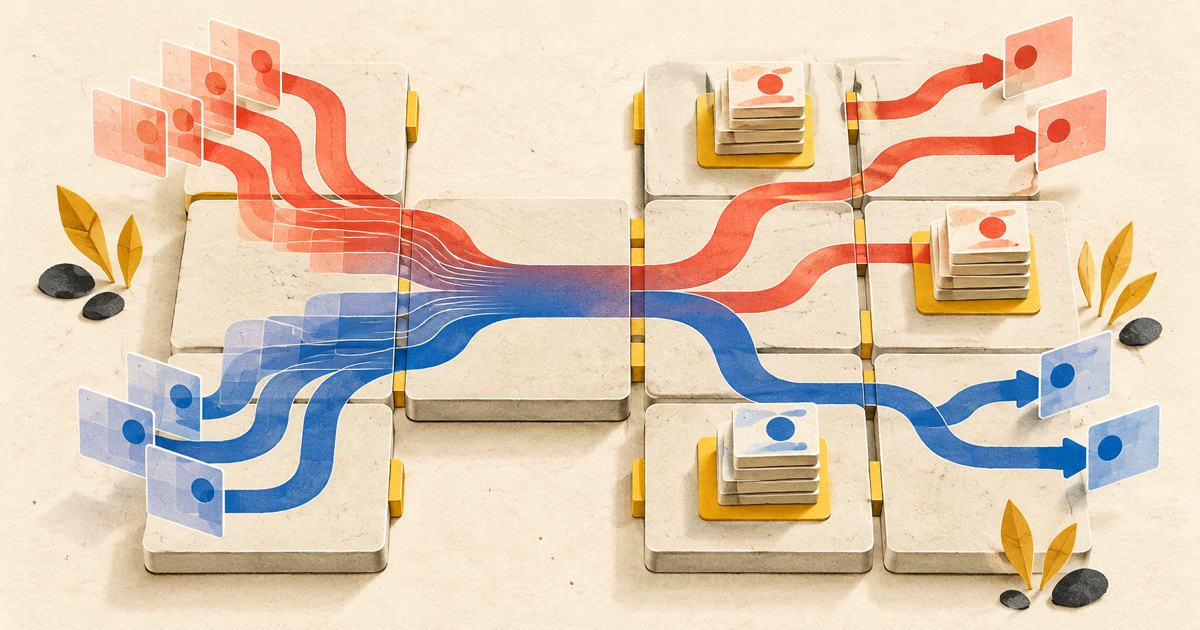
モデルへの要求はプロキシが別GPUへ振り分け直す。エージェントのハーネス、作業領域、ツールの状態をGPU外に置くため、役割変更のたびに進行中の仕事を捨てずに済む。さらに、圧縮、サブエージェント、再試行で枝分かれした履歴を、共通の前半部分を共有する木構造へ変換し、重複を除いた訓練サンプルにする。タイムアウト時の途中経過も無条件で使うわけではなく、保存状態を採点できて正式な報酬を得た実行だけが対象になる。
「最大1.85倍」は2.4T実験の数字ではない
著者らのQwen 3.8 2.4Tを使ったNL2RepoBench実験では、48ステップの所要時間はQwenGyreが75.42時間、Asyncが134.55時間、Colocateが91.47時間だった。したがって同条件での高速化はAsync比1.78倍、Colocate比1.21倍となる。X投稿の「Colocate比で最大1.85倍」は、Qwen 3.6 122Bを使った別のワークロードや設定を含む最大値だ。性能値は著者らの実験結果であり、独立した再現結果ではない。
規模も見逃せない。2.4T実験は48ノードのセルを4個、合計192ノードで行い、推論の同時実行上限は384だった。全実験ではClaude Code 2.1.220をコンテナで動かし、GSPOの独自適応版を使っている。著者ら自身も、大幅に少ないGPU予算での効率は未評価としている。QwenGyreの面白さは計算資源の使い方にあるが、その効果を得る前提もまた大きい。
いま読者が試せるものは限られる
10月13日時点で、QwenGyreの公式コード、導入手順、ライセンス、配布物は確認した一次資料に示されていない。第三者がすぐ導入できる公開ツールとはまだ言えない。NL2RepoBenchのREADMEには104タスクのローカル実行とDockerイメージの準備方法があるが、論文は内部の訓練データと別の評価器も使用しており、READMEだけで実験環境を再現できるわけではない。
使う側から見ると、現段階の価値は完成品というより設計の提示にある。長時間の分岐実行では、モデルの更新だけでなく、進行中の状態を保った資源移動と軌跡の重複削減が大きな改善点になり得る。ただし公開実装と小規模環境での評価が出るまでは、論文の大規模クラスタで得た数字として読むのが妥当だ。