Editor’s Note
XピックアップGoogle DeepMind、EmbeddingGemma 2を公開 画像・音声も同じ空間で検索
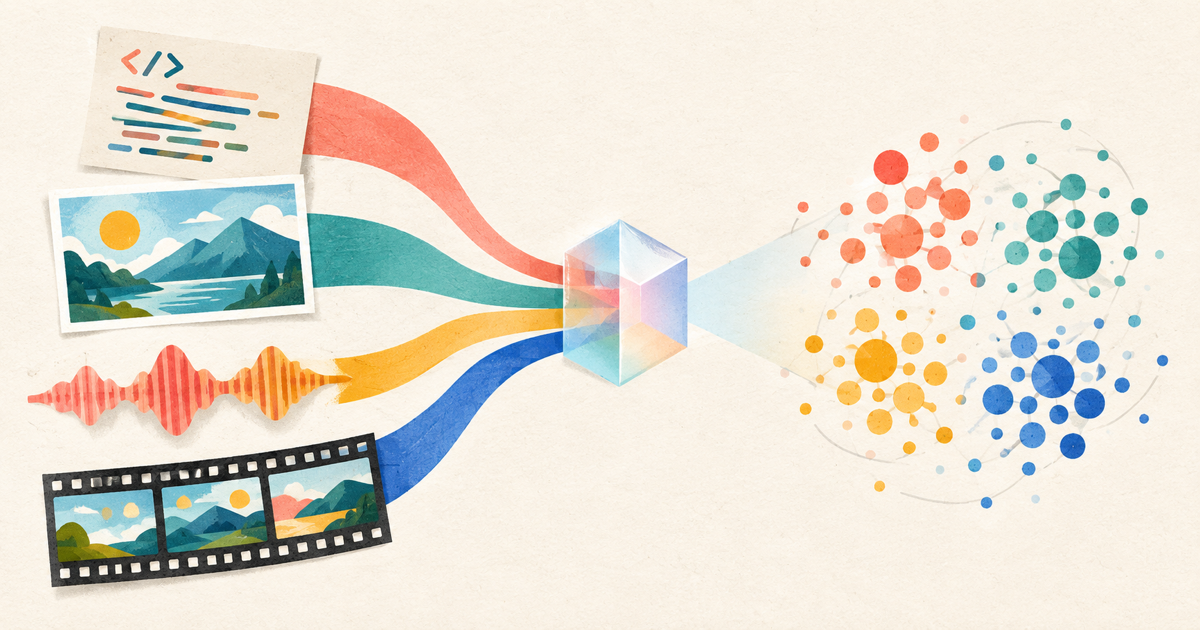
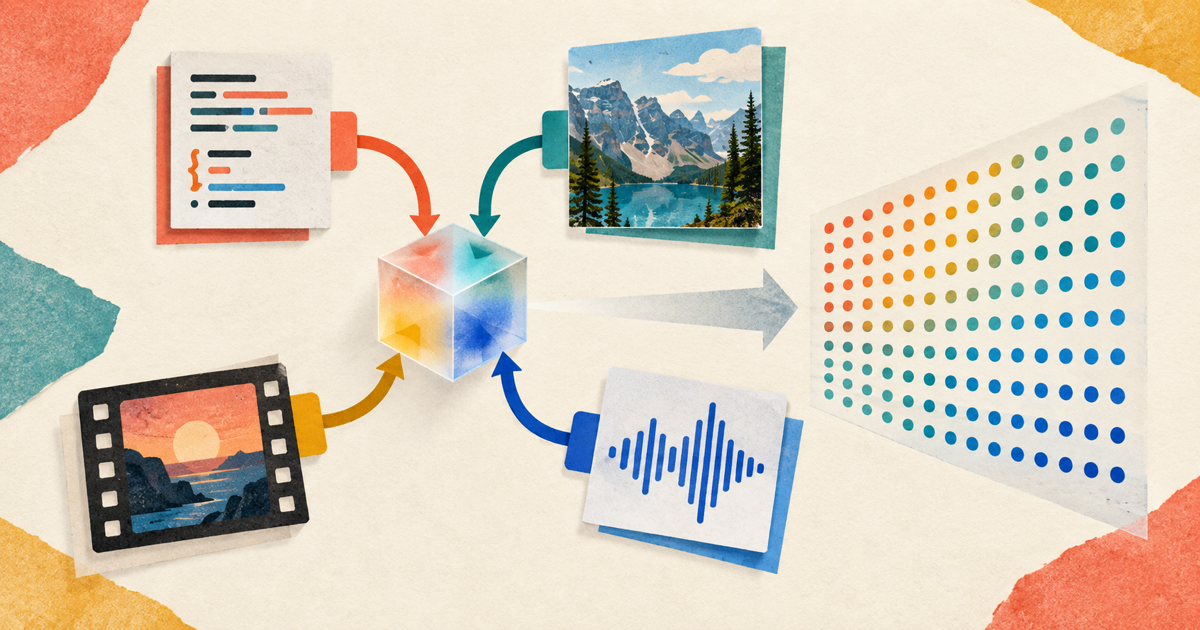
Google DeepMindは日本時間10月7日、最大7億4000万パラメーターのEmbeddingGemma 2を公開した。変わったのはサイズだけではない。テキスト専用だった旧版を、コード、画像、動画、音声まで同じ768次元の空間へ写すモデルに拡張した。音声メモで動画内の場面を探す、といった検索を一つの仕組みで組み立てられる。
全部入りにも、必要な分だけにもできる
モデルカードによると、構成はテキスト部分270M、視覚エンコーダー170M、音声エンコーダー300M。すべてロードすれば740Mだが、テキストだけなら270M、テキスト+視覚なら440M、テキスト+音声なら570Mに抑えられる。端末内検索で音声を使わないなら、その分まで常駐させなくてよい。このモジュール性が、単なる小型化より実用上のポイントだ。
Googleが示した旧版との比較では、多言語MTEBが61.15から61.36とほぼ横ばいなのに対し、Code MTEBのNDCG@10は68.76から78.68へ上昇。画像・動画・音声の評価も新たに加わった。開発者向けガイドで全モダリティーを使うには、Sentence Transformers 6.1.0以降と画像・音声・動画用の追加依存関係が必要になる。
公式Xは、2倍超の規模を持つ一部の専用モデルを上回るとも説明している。ただし、確認した公式記事と評価表からは該当モデル名と比較値の組み合わせを特定できない。これはGoogleの性能主張として受け取り、用途に合う検索精度は手元のデータで見るのがよさそうだ。
ベクトルを縮めると、検索品質も動く
保存量を減らすため、768次元のベクトルを先頭128次元へ短縮できる。容量は6分の1になる一方、モデルカードのMMEB総合値は59.01から45.65へ低下する。短縮後の再正規化が必要で、検索するクエリー側と文書側の次元も揃えなければならない。大量データを置く場合、容量と精度の交換条件はかなり具体的だ。
数値精度にも注意したい。推奨はbfloat16またはfloat32で、float16はNaNや、エラーを出さないままの品質低下を起こし得る。公表ベンチマークはフル精度のチェックポイントによる値で、量子化版でも同等だと示すものではない。
Google AI Edge Galleryの検索デモは公開済み。一方、AndroidのML KitサービスとNPUアクセラレーションは、Google AI Edge TeamとAndroid ML Teamが10月6日時点で「今後数週間」とした計画であり、10月7日の確認時点では提供済み機能とは分けて見る必要がある。まずは必要な入力だけで構成し、次元数と精度を固定して評価するのが、いちばん堅実な試し方だ。
参考資料
- EmbeddingGemma 2公式発表
- EmbeddingGemma 2モデルカード
- EmbeddingGemma 2: The Developer Guide
- sentence-transformersのリリース一覧
- Google AI Edgeでのマルチモーダル検索