Editor’s Note
XピックアップPerplexity、判定モデルpplx-decider-v1.1-27bを公開 基盤維持で評価を改善
Hugging Face公式Xは日本時間10月7日、Perplexity Developersによる「pplx-decider-v1.1-27b」の公開投稿をリポストした。文章や画像から答えを生成するモデルではなく、入力を読み、候補の選択や採点を担う27Bのマルチモーダル判定モデルだ。v1.1では基盤モデルを大型化せず、入力の見方と学習データを変えて評価値を伸ばしたとしている。
同じ27B基盤で、入力全体を見る
モデルカードによると、v1.1はv1と同じQwen3.8-27B基盤を維持する一方、すべての注意層で因果マスクを外し、後ろの情報も含めて入力全体を参照できる非因果的アテンションへ変更した。さらにtasksourceを含む追加データで学習している。
Perplexityが掲載したDecision Indexは、v1の56.4からv1.1の61.56へ上昇し、比較対象のJevは57.9だった。これは提供元のモデルカードにある評価で、こちらで再計測した結果ではない。「パラメーター数を増やしたから強くなった」のではなく、判定専用の読み方とデータを詰め直した点が今回の差だ。
APIなら三種類の判定を一度に扱える
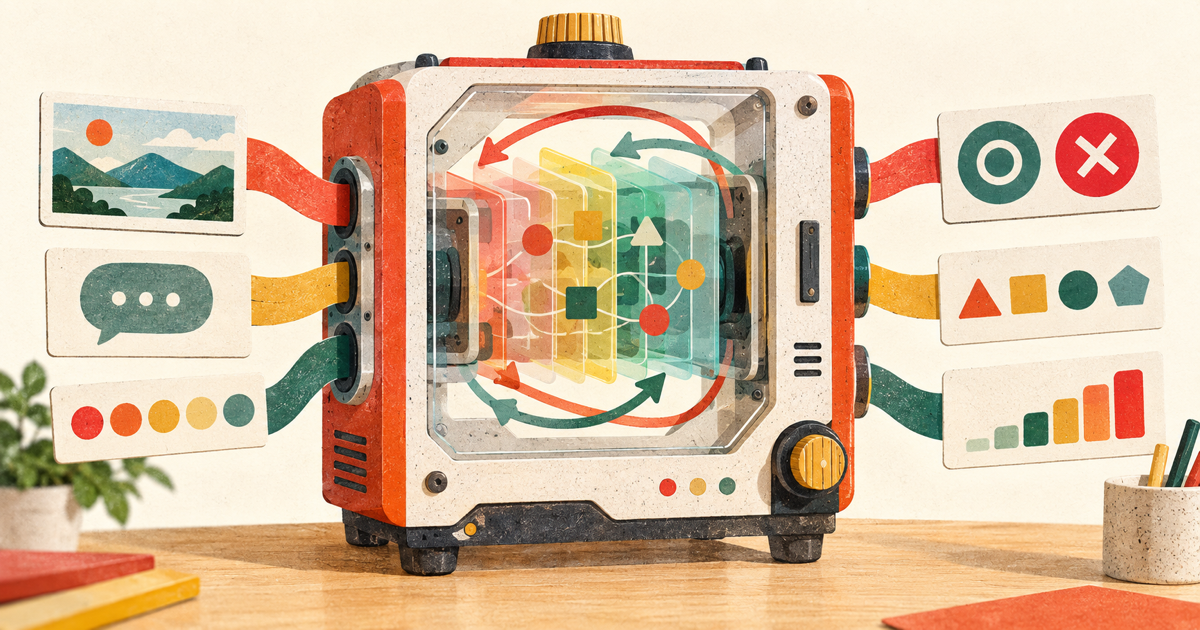
ホスト型のDecisions APIでは、v1.1とv1を明示して選べる。一つのリクエストに、二値確率を返すnoul、候補を選ぶchoice、段階評価のscoreを混在させられる。たとえば一件のレビューから、欠陥の有無、感情の分類、深刻度の採点をまとめて取り出す、といった処理だ。生成モデルへ長い指示を書いて返答形式を整えるより、判定項目を固定した処理に向く。
10月7日に確認した公式料金表では、v1.1とv1はいずれも入力100万トークン当たり0.02ドルで、出力料金とリクエスト料金は無料となっている。Perplexity側の投稿にある「v1の半額」という比較は、現行表では両モデルが同額のため、基準となった旧価格や適用期間を確認できない。発表時の比較と現在の利用条件は分けて見たい。
首位評価の大半は非公開、ローカル運用も軽くない
Decision Index 0.3の構成は、公開ベンチマーク20%、同じ技能を測る非公開テスト50%、新領域の非公開課題30%だ。つまりFullスコアの80%は非公開部分で、第三者が公開データだけから総合首位を完全に再現することはできない。数値は有力な比較材料だが、採用前には自分の判定項目でも精度を見る必要がある。
ローカル実行にはPython 3.12以降、認証済みHugging Faceアクセス、CUDA GPUが必要で、約49GiBの重み用容量に加えて作業メモリも要る。通常の因果推論では評価時の挙動を再現できず、付属実装、保存済みの温度較正、生成モデル用lm_headとは異なる専用readoutを使う必要がある。モデルカードはApache-2.0を掲げる一方、認証済みアクセスが必要なprivate repositoryとも説明しており、承認条件や恒久的な公開範囲は明記されていない。まず試すならAPIが近道で、自己ホストは実装とGPU環境まで含めて検討するモデルだ。
参考資料
- perplexity-ai/pplx-decider-v1.1-27b
- Answer questions — Decisions API
- Pricing — Perplexity API
- Decision Index 0.3 commit