Editor’s Note
XピックアップNVIDIA PAIR、MacやRTX PCへローカルAI処理を分散する無料β版を公開
2026年9月4日
2分
AI観測
#NVIDIA PAIR#ローカルAI#オープンソース#AIエージェント
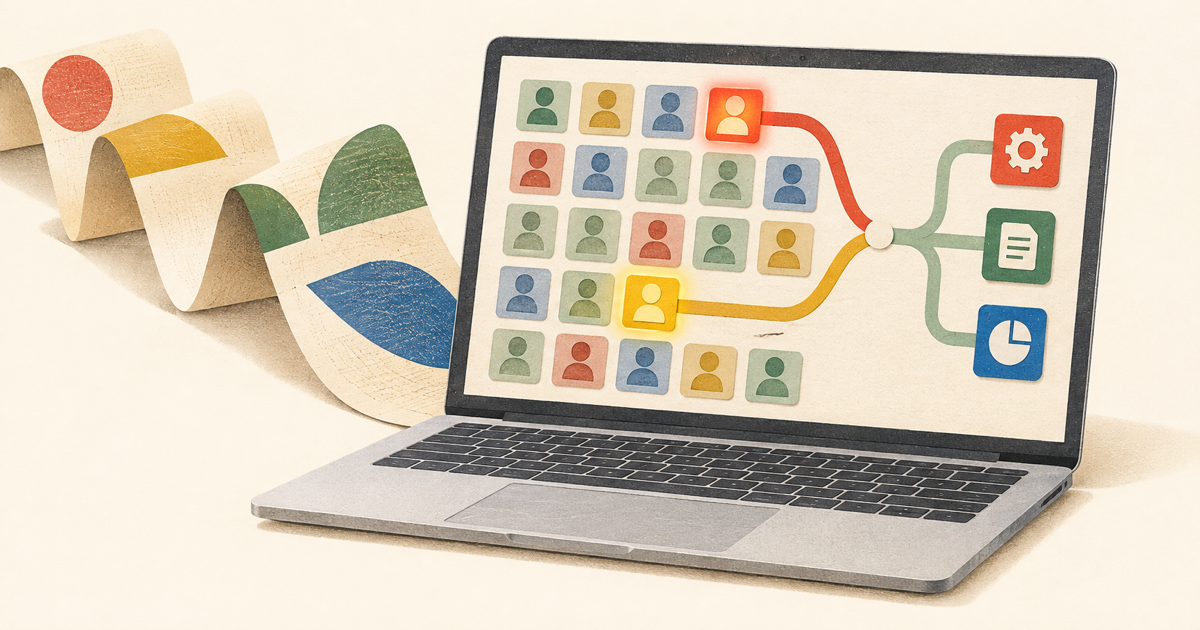
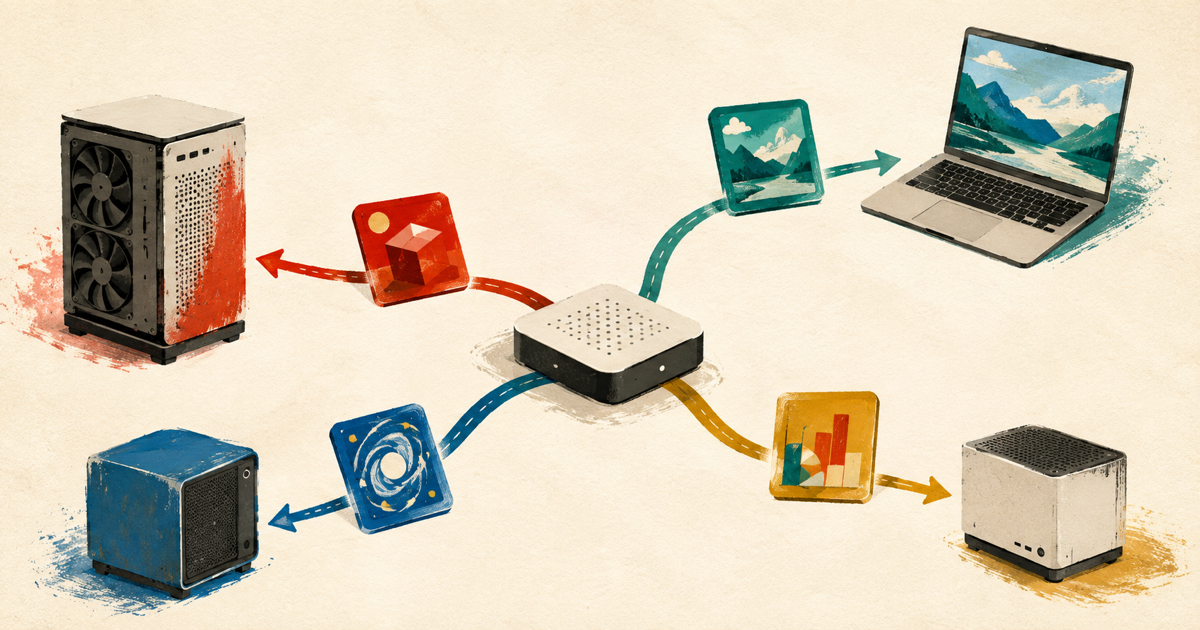
Jaime Medina氏(@itsjaimemedina)が、NVIDIA PAIRの無料・オープンソースのベータ版が利用可能になったと紹介した。同じネットワークにあるM4以降のMac、RTX PC、DGX Sparkへ、ローカルAIのリクエストを振り分ける仕組みだ。複数のAI作業を同時に走らせたい開発者には、一台の計算資源だけに集中させない選択肢になる。
手元の機材を役割で分ける
投稿では、例えば次のような構成が挙げられている。
- M4 MacでIDEやツール、エージェントの実行基盤を動かし、選んだモデルだけRTXデスクトップに置く
- 計画、テスト、セキュリティレビュー、文書作成を同時に進め、モデルへのリクエストを別々の端末へ配置する
- 小さなコーディングモデルはMac、画像を扱うモデルはRTX、大きな推論モデルはDGX Sparkというように置き分ける
同じコーディングモデルを複数台へ入れれば、同時リクエストの送り先も増やせる。アプリ側にはOllamaまたはLM Studioのエンドポイントを一つ見せつつ、利用できる端末がネットワークへ参加したり離れたりする構成も想定されている。
一つの応答が速くなる仕組みではない
ここは誤解しやすい。PAIRはエージェントを作らず、メモリを統合せず、一つのモデルを複数端末へ分割もしない。各リクエストは、条件に合う一台の端末で最初から最後まで処理される。
つまり効くのは、一つのチャットの生成速度ではなく、並行できる仕事の処理量だ。開発タスクを複数のエージェントへ分けている人ほど、手元に散らばった機材をまとめて使う意味が見えやすい。一方、単発の会話を速くしたいだけなら、期待する効果とは違う。