Editor’s Note
XピックアップReflection AI、501BのMoE「Beam」を予告 重みとOllama提供形態は未公開
Reflection AIは10月5日付で、同社初のオープンウェイトモデル「Beam」を発表した。Ollamaも日本時間10月6日にこの発表を引用し、「米国発のモデルがさらにOllamaへ来る」と期待を示している。ただし10月7日現在、Beamの重みも技術報告も未公開で、Ollamaでの提供方法や時期も示されていない。大規模モデルの予告と、手元で動かせる状態は分けて見る必要がある。
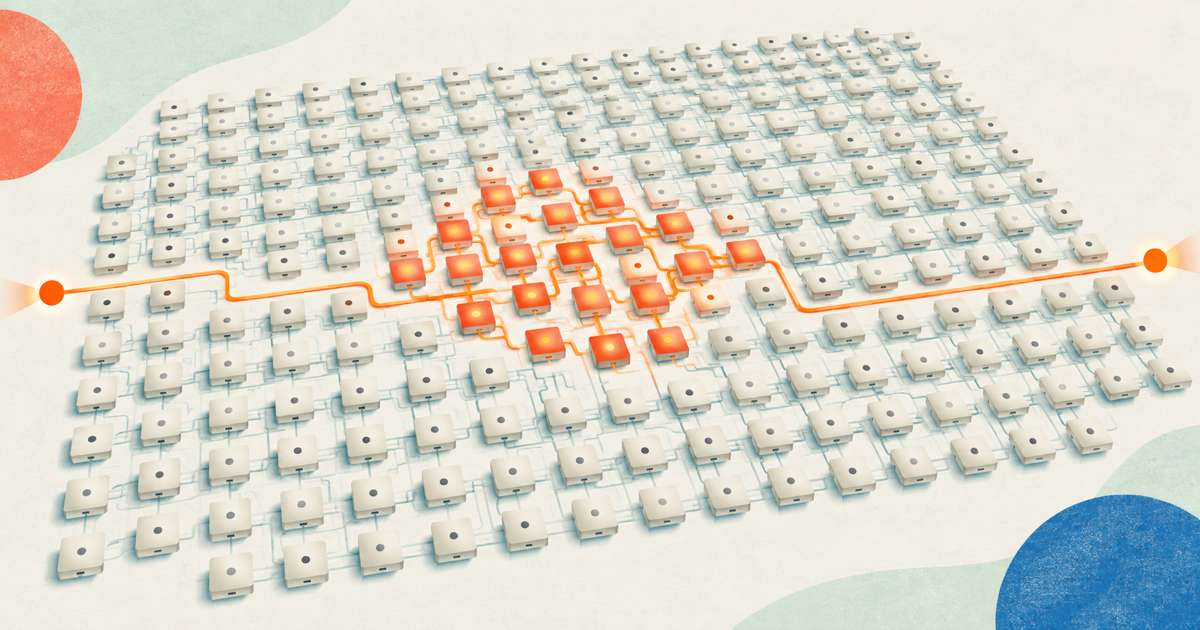
501Bの全体から23Bを動かす
Reflection AIの発表によると、Beamは総501Bパラメータのうち推論時に23Bを活性化する疎なMixture-of-Experts(MoE)モデルだ。巨大な全体を毎回すべて動かすのではなく、処理に使う部分を絞る設計で、コーディング、推論、エージェント型処理を主用途に掲げる。
一方で、Beamはテキスト専用だ。画像などを扱うにはOCRや外部APIで文字情報へ変換する必要があり、ネイティブなマルチモーダルモデルではない。利用者が「reasoning effort」を調整し、短い応答と長い推論の配分を変えられるとも説明されているが、具体的なAPI仕様や公開版での設定方法はまだ出ていない。
「3〜4倍少ない計算量」は実測コストではない
Reflection AIは、BeamがGLM 5.2級の推論結果を3〜4倍少ない推論計算量で達成すると主張する。ただし、Kimi K3には素の能力で及ばないとも明記しており、比較対象を一律に上回るという発表ではない。
さらに、この効率値は活性パラメータ数と生成トークン数から求めた概算だ。プロンプトを最初に読み込むprefill、長い文脈に応じて増えるAttention計算、配信基盤のオーバーヘッドは含まれない。したがって、3〜4倍という数字を、そのまま実機の速度や利用料金の差とは読めない。技術報告が公開されるまでは、提供側の性能主張として受け止めるのが妥当だ。
今は早期版とウェイトリストの段階
現時点の提供は選定ユーザー向け早期版とウェイトリストに限られる。Reflection AIは2026年10月中に、Apache 2.0の重み、技術報告、モデルカード、実行・評価・ファインチューニング用スタックを公開すると予告している。しかし、10月7日に確認したReflection AIの公式Hugging Face組織には公開モデルが0件で、一般公開済みとは確認できない。
Ollamaの投稿も、Beamをローカルモデルとして出すのか、クラウド経由なのか、あるいは両方なのかを明記していない。タグ、量子化形式、必要メモリ、対応ハードウェアも未発表だ。使う側から見ると、まず重みとモデルカード、次にOllamaでの具体的な配布形態がそろって、ようやく導入判断を始められる段階にある。