Editor’s Note
XピックアップOllamaにEmbeddingGemma 2、画像を含む埋め込みへ拡張 音声・動画は表示に食い違い
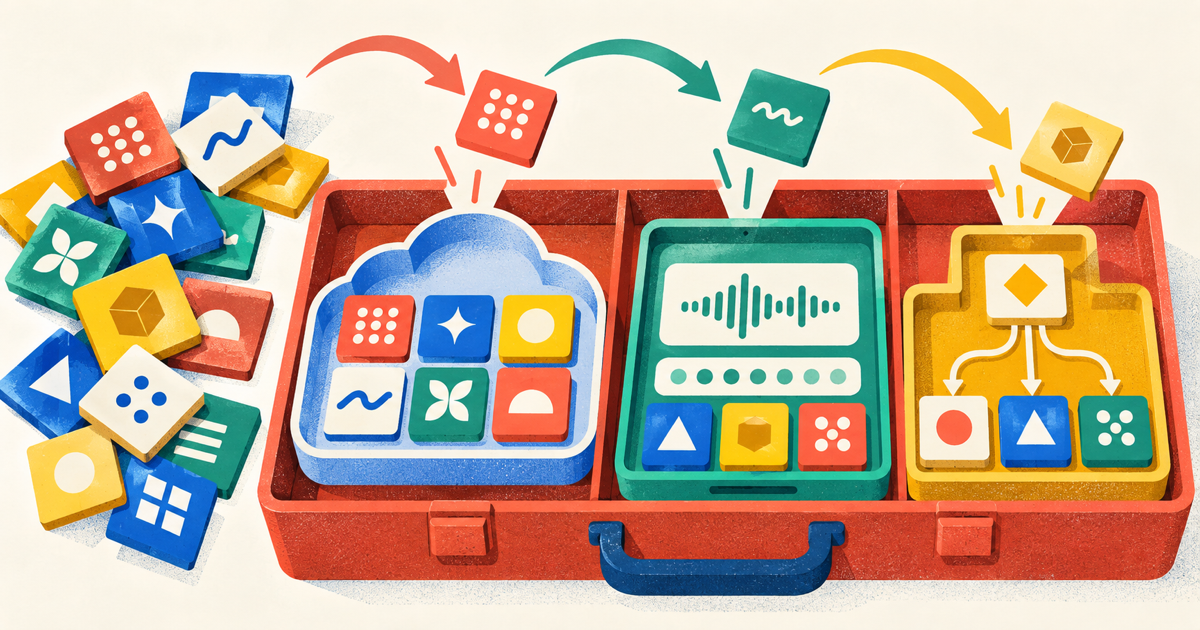
Ollamaは、Google DeepMindの「EmbeddingGemma 2」を利用可能にした。ollama pull embeddinggemma-2で取得でき、ローカルの/api/embedを使うcURL、Python、JavaScriptの例も公式ライブラリページに載っている。埋め込みモデルをローカルで使う人にとって、今回の変化はテキストだけでなく、画像など異なる形式の情報を同じ物差しで検索できる方向へ踏み出したことだ。
旧版のテキスト専用から、共有768次元空間へ
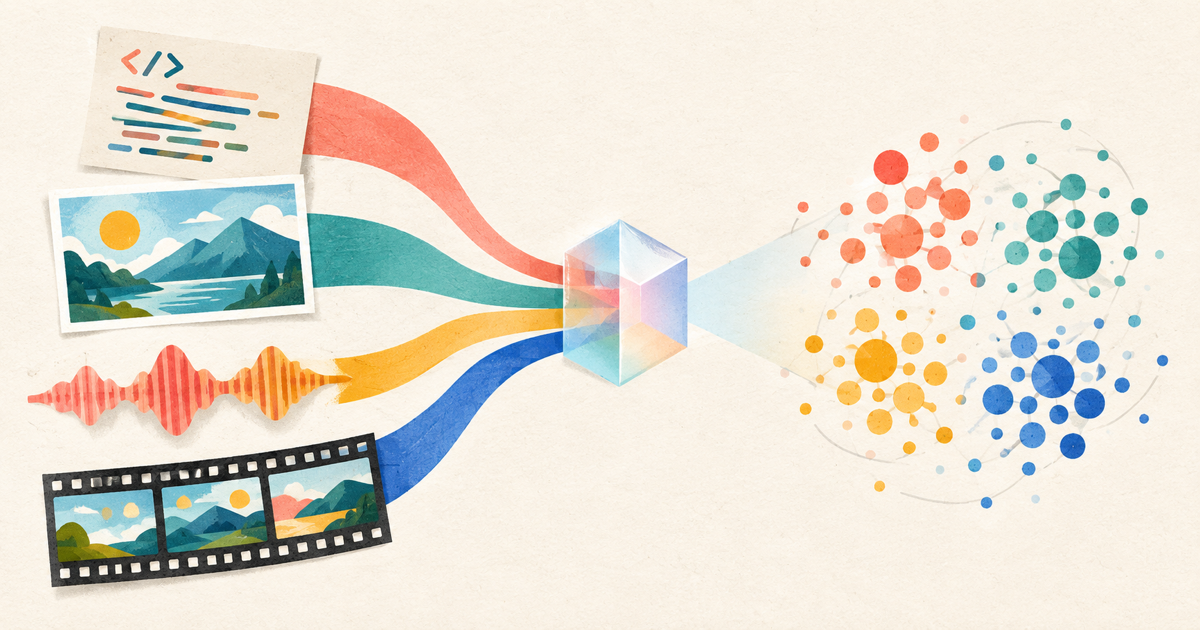
Googleの仕様によると、旧EmbeddingGemma 1はGemma 3を基盤とする308Mパラメータのテキスト埋め込みモデルで、コンテキスト長は2Kだった。EmbeddingGemma 2はGemma 4ベースとなり、基本のテキスト/コード部分を270Mへ縮小しながら、画像・音声・動画を含む共有768次元空間と8,192トークンへ広げている。
使い道は、文章から画像を探す検索、音声クエリによる動画検索、マルチモーダルRAG、分類やクラスタリングなどだ。モデルカードでは、テキストのみ270M、テキスト+画像440M、テキスト+音声570M、全機能740Mという構成が示されている。必要なエンコーダーだけを選び、端末側のメモリ負担を調整できる設計だ。重みはApache 2.0で提供され、Googleは消費者向けCPUまたはGPUでローカルかつオフラインに動かせるとしている。
Ollamaで今すぐ使える範囲は、表示を見極めたい
ここは少し慎重に見たい。Googleのモデルカードは740M版をテキスト・画像・音声・動画対応としている一方、2026年10月7日に確認したOllamaのタグ一覧では、latest/740Mは「Text, Image input」と表示され、名前にtext-audioを含む570Mタグも「Text input」となっている。Ollama経由で音声・動画をどう渡すのか、対応する最小バージョンも公開ページからは確認できない。したがって、現時点で4種類すべてをOllamaから扱えるとまでは断定できない。
入力上限の表示も、Googleの仕様とOllamaページ内READMEは8,192トークン、タグ一覧は256Kコンテキストとして食い違う。まず試すなら、公式例があるテキスト埋め込みや、タグに明記された画像入力から始めるのが現実的だろう。なお、モデルを直接扱う場合、Googleはfloat16でNaNや品質低下が起こり得るためbfloat16かfloat32を推奨し、128次元への短縮はマルチモーダル品質を大きく下げる可能性があるとしている。小さく動かせることと、用途に十分な検索品質が出ることは分けて検証したい。
参考資料
- Ollama:embeddinggemma-2
- Ollama:EmbeddingGemma 2のタグ一覧
- Google AI for Developers:EmbeddingGemma
- Google AI for Developers:EmbeddingGemma 2 model card