Editor’s Note
XピックアップOpenClaw v2026.9.8公開、GPT-6.1 Sol対応と委譲結果の返信を修正
OpenClawは10月3日、v2026.9.8を公開した。GPT-6.1 Solへの対応が目を引くが、複数のエージェントに仕事を渡す運用では、委譲結果を依頼元へ確実に一度返す変更のほうが日々の安心に直結する。アイドル時のCodex関連プロセスも整理され、派手さより信頼性を整えた更新だ。
GPT-6.1 Solは自動では選ばれない
モデル資料によると、GPT-6.1 Solを使うにはopenclaw models set openai/gpt-6.1-solで明示的に選ぶ必要がある。OpenAI APIキー、または同モデルが提供されているChatGPT/Codex契約も前提で、OpenClawが対応しただけで各アカウントに利用権が加わるわけではない。
従来のGPT-6 Solでは推論をnoneにできたが、GPT-6.1 Solは推論を無効化できない。既定はmediumで、minimalを指定してもlowへ変換される。公称コンテキストは105万トークン、最大出力は12万8千トークン。ただしOpenClawで通常使う入力予算の既定値は27万2千トークンで、ネイティブCodexでは選択したアカウントのモデルカタログ上限に従う。対応モデル名だけでなく、推論設定と実際の入力枠まで見て切り替えたい。
委譲の完了を依頼元まで届ける
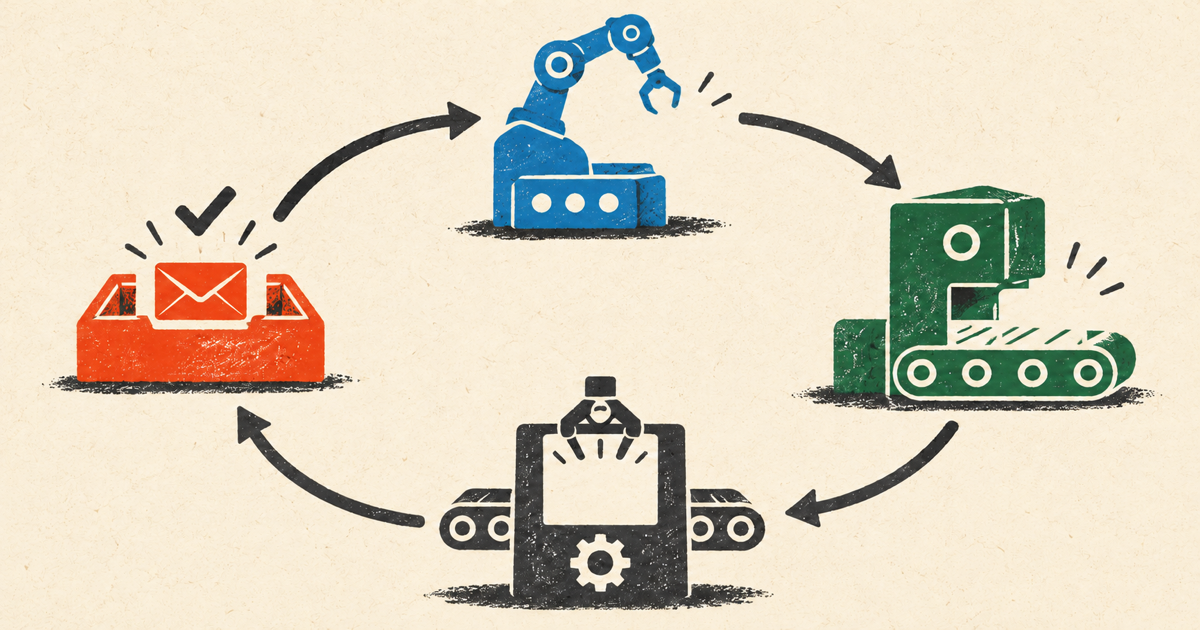
リリースノートとメッセージ仕様では、別エージェントへ渡した仕事の結果を、即時または完了後に元の依頼者へ一度だけ返すようになった。内部セッションはNO_REPLYのまま完了できず、追加の往復や外部への配信には、明示的なフォローアップかメッセージ呼び出しが要る。
運用面で大切なのは、「処理が終わった」だけでなく「依頼した側が結果を受け取った」までを一つの完了経路にしたことだ。長く動く調査やサブエージェントへの分担では、この小さな差が、返答待ちのまま止まるケースを減らす。
メモリ削減はアイドル時の仕組み
公式ノートの「メモリ使用量削減」は、推論全体が一律に軽くなるという意味ではない。アイドル中のCodexエージェントごとにセッションカタログ用プロセスを常駐させず、必要時に起動して互換設定を共有する変更だ。最初のカタログ要求では従来どおり保留応答が出る場合があり、削減量や普遍的な速度向上も示されていない。
つまりv2026.9.8は、新モデルを足しただけの版ではない。モデル選択の条件を明確にし、委譲の戻り道をつなぎ、待機中の無駄を狙って減らした。10月3日に確認した現行資料の範囲では、使う側が期待値を置きやすくする更新といえる。
参考資料
- OpenClaw Documentation:v2026.9.8
- GitHub:Release openclaw 2026.9.8
- OpenClaw Documentation:OpenAI models
- OpenClaw Documentation:Messages
- OpenClaw Documentation