Editor’s Note
XピックアップNVIDIA「Nemotron 3 Diarization」公開、重なる声を最大8話者まで追跡
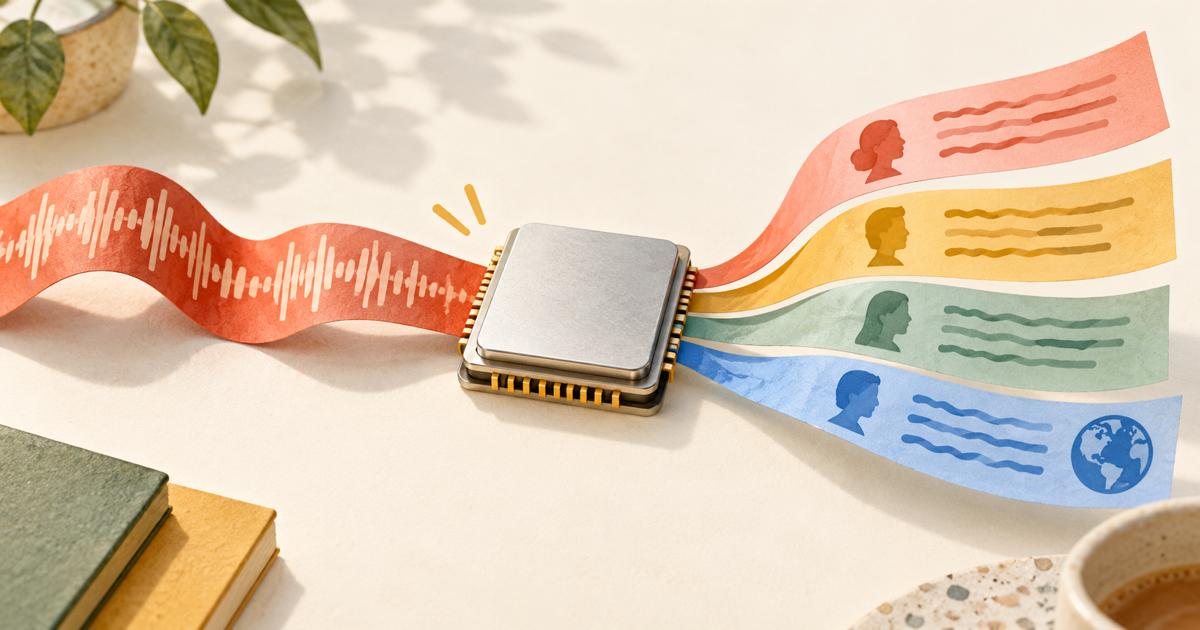
NVIDIAは9月23日、100Mパラメータのオープンウェイトモデル「Nemotron 3 Diarization」をGeneral Accessとして公開した。会話が重なっても、誰がいつ話したかを最大8話者まで追跡できる。Prince Canuma氏はXでMLX-Audioへの対応を予告したが、こちらは公開済み機能と分けて受け止めたい。
4話者から8話者へ
新モデルは一つのチェックポイントでストリーミングとオフライン推論に対応する。モデルカードとNVIDIAの解説によれば、従来のStreaming Sortformerが最大4話者だったのに対し、上限を8話者へ広げた。会議だけでなく、人数の多い通話やポッドキャストを扱いやすくなる更新だ。
一方、設計の軸は旧モデルから続いている。話者を最初に登場した順で並べ、ストリームをまたいで情報を保つAOSC・FIFOの方式だ。旧モデルの公式解説と原論文を合わせると、今回は追跡の考え方を入れ替えるより、同じ流れをより大人数へ拡張したモデルと見るのが近い。
文字起こしでも、本人確認でもない
入力は16kHz・モノラル音声で、WAV、FLAC、OPUS、MP3に対応する。出力は speaker_2 のような匿名ラベルと発話の開始・終了時刻だ。ASR(音声認識)の結果と組み合わせれば話者付き文字起こしを作れるが、このモデル単体は発言内容を文字にせず、ラベルから現実の人物も特定しない。
リアルタイム性にも小さな現実がある。公式資料の推奨ストリーミング設定には30.4秒、1.04秒、0.64秒、0.32秒の時間値が並び、技術上は80ミリ秒も設定できるものの、推奨下限は0.32秒とされる。しかも、これらには計算、通信、ASR、アプリ側の処理時間は含まれない。提供者は固定の最大音声長を設けていないとしているが、非常に長い録音や強い雑音・残響、遠距離収音では性能低下の可能性も明記している。低遅延という言葉だけで、完成アプリの応答速度まで決めつけないほうがよい。
MLX-Audio対応はまだ予告段階
9月24日に確認したMLX-AudioのSortformer文書が挙げる対応モデルはv1と4話者版v2.1で、Nemotron 3 Diarizationは掲載されていない。実装PR、対応バージョン、公開予定日も一次資料では確認できなかった。つまり元投稿の「Coming to MLX-Audio」は期待できる予告ではあるが、MLX-Audioから今すぐ使える統合版の告知ではない。
参考資料
- NVIDIA:Nemotron 3 Diarizationモデルカード
- NVIDIA:Nemotron 3 Diarization公式解説
- NVIDIA:Streaming Sortformer公式解説
- MLX-Audio Sortformer README
- Streaming Sortformer原論文