Editor’s Note
XピックアップLiquid AI、LFM2.5-VL-3B向けDSparkを公開 デコード最大3.13倍と報告
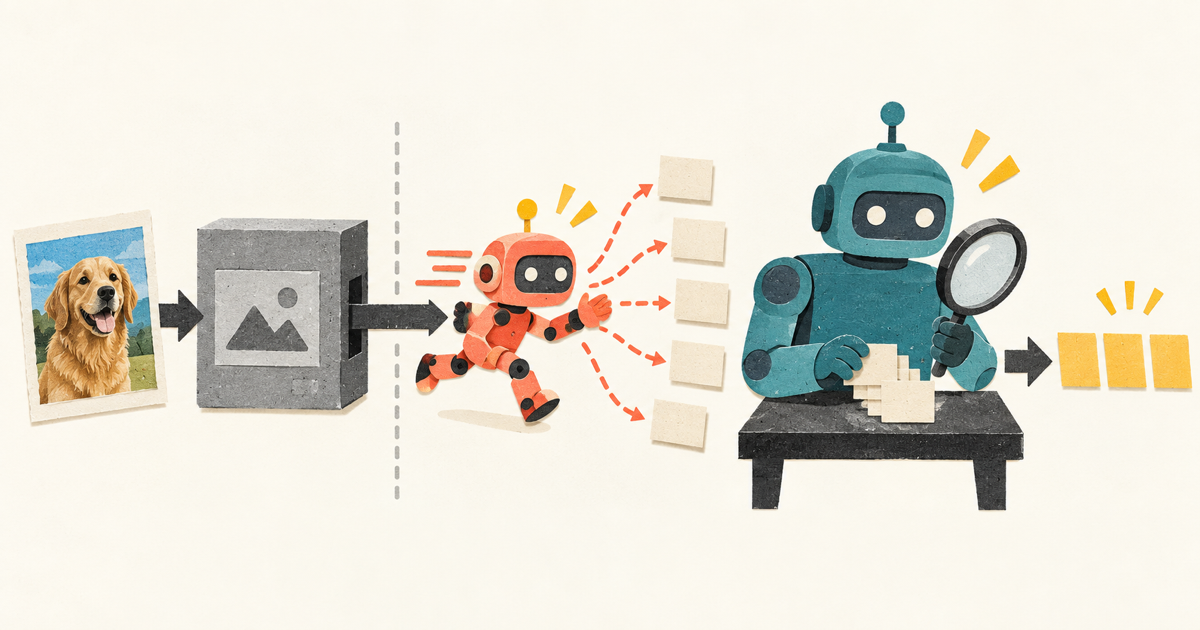
Liquid AIが9月24日、LFM2.5-VL-3B専用の実験的ドラフトモデル「LFM2.5-VL-3B-DSpark」を公開した。軽量モデルに少し先まで候補を出させ、元のVLM(画像と言葉を扱うモデル)がまとめて検証する「投機的デコード」により、出力品質を変えず生成を速める狙いだ。Prince Canuma氏は9月25日2時6分ごろ(日本時間)、MLX-VLMで公開初日から対応したと紹介した。画像を理解する能力を入れ替えるのではなく、回答を書き出す待ち時間を削る技術である。
最大3.13倍、ただし速いのは生成部分
DSparkは約2億7,950万パラメータの専用ドラフターで、単独で使う新しいVLMではない。Liquid AIの発表によると、6種類の視覚言語タスクをバッチサイズ1、temperature 0で測定し、M5 Max上のMLXではデコードが最大3.13倍、処理全体が最大2.62倍になった。M3 Ultra上のllama.cppはそれぞれ2.14倍と1.77倍、H100上のSGLangは2.66倍と2.27倍だったという。いずれも提供側の測定で、今回こちらで再現した結果ではない。
デコード倍率と全体倍率に差があるのが大事なところだ。高速化されるのはトークンを生成するフェーズだけで、画像エンコーダーとprefill(入力を最初に読み込む処理)は変わらない。公開評価は視覚エンコーダーと言語モデルを16-bitで動かした条件で、量子化モデルは評価範囲外だ。モデルカードもこの制約を明記している。画像処理や長い入力の比重が大きい用途では、3.13倍という数字がそのまま体感速度になるわけではない。
導入は「正しい組み合わせ」が前提
9月26日時点のモデルカードでは、Safetensors版ドラフターはLFM2.5-VL-3B、GGUF版はLFM2.5-VL-3B-GGUFとの組み合わせが指定されている。Apple SiliconではMLX-VLM v0.7.2以上が必要で、ターゲットモデルとドラフターを同時に指定し、temperature 0、draft block size 8で使う。SGLangはv0.5.19以上が条件だ。
この対応は単なる重みの追加ではない。MLX-VLMでは以前、VLM側のラッパーが投機実行に必要な中間状態(hidden states)などを渡せず、テキスト版LFM2用のドラフターを組み合わせられなかった。マージ済みの変更で、検証とキャッシュの巻き戻しまで使えるようになった。SGLangも、必要な属性を言語モデルへ委譲する対応変更を9月22日にmainへ取り込んでいる。
使う側から見ると、画像への質問に長めの回答を返すなど、処理全体に占める生成時間が大きい場面ほど恩恵を見込みやすい。一方、llama.cpp対応がどの正式リリースタグや配布ビルドから確実に入るかは、今回の一次資料では特定できなかった。まずは対応版とモデルの組み合わせを確認し、デコードだけでなく処理全体の時間で比べるのが現実的だ。
参考資料
- Liquid AI:LFM2.5-VL-DSpark発表
- Hugging Face:LFM2.5-VL-3B-DSparkモデルカード
- MLX-VLM:投機的デコード対応PR
- SGLang:DSpark対応PR