Editor’s Note
XピックアップEmbeddingGemma 2、Apple silicon向けMLX版が即日登場 全機能には特定版が必要
Googleは10月6日、テキスト・画像・音声・動画を一つの空間へ写せる「EmbeddingGemma 2」を公開した。Prince Canuma氏は日本時間10月7日、Apple silicon上で動かすMLX-VLM向けモデルが即日用意されたと紹介している。Macだけで複数種類のファイルを横断検索できる可能性は魅力的だが、現状は一行のpipで全機能がそろう段階ではない。
テキスト専用から、4種類のメディアを同じ物差しへ
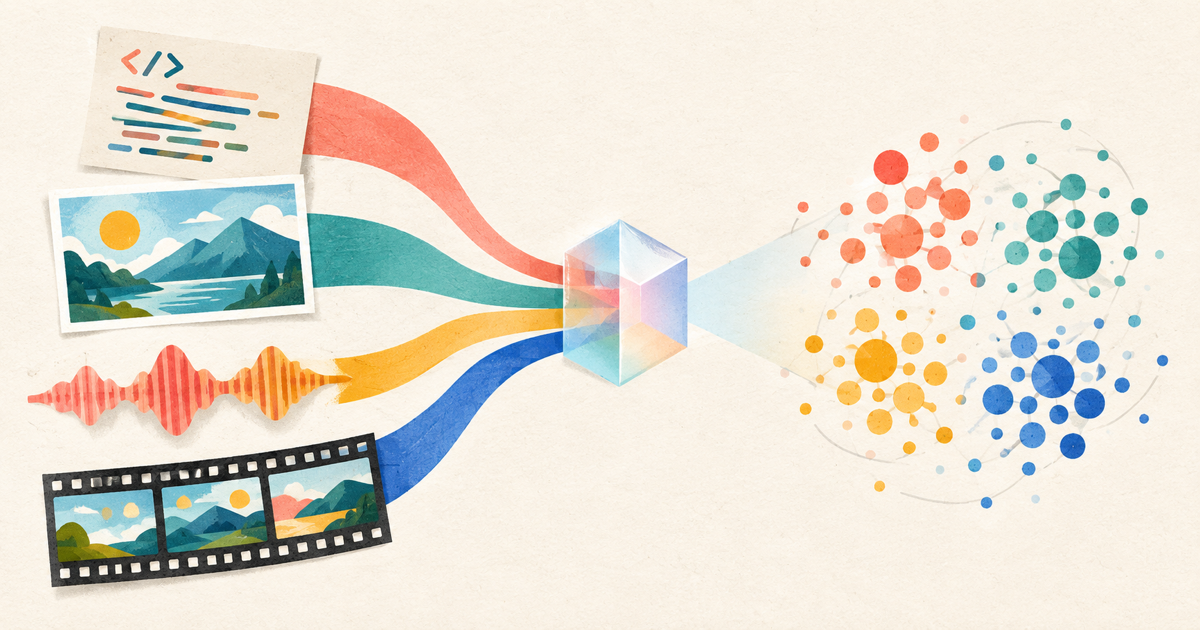
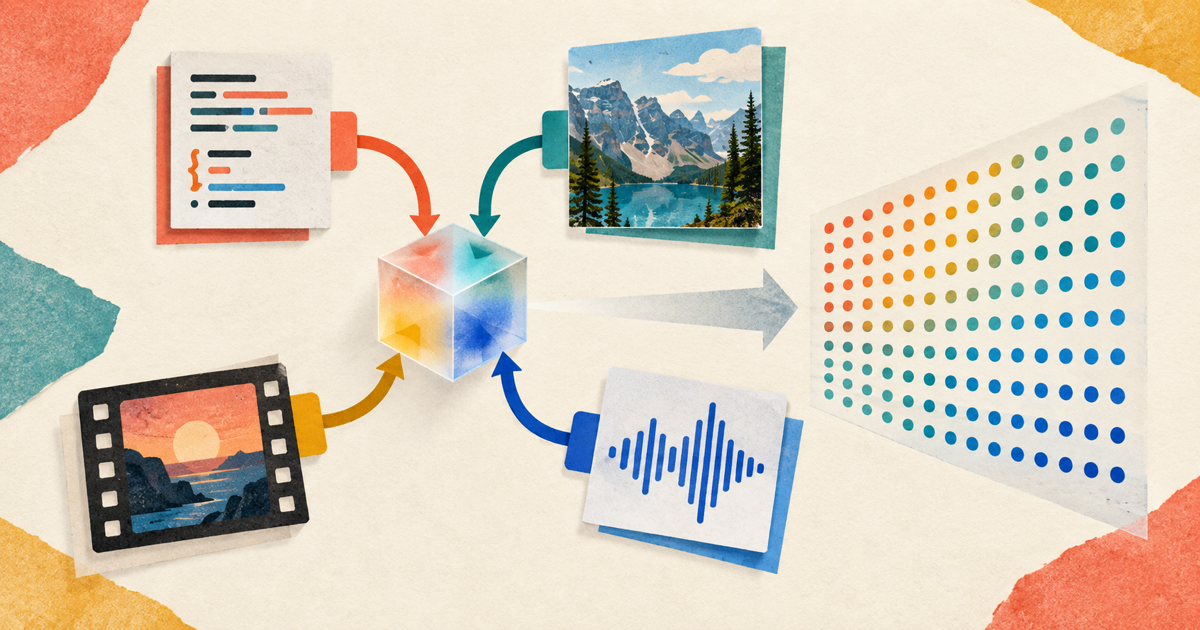
Googleの発表と公式モデルカードによると、旧EmbeddingGemmaのテキスト中心の構成に対し、新版はテキストとコード、画像、動画、音声を共有する768次元空間へ変換する。たとえば文章で写真を探したり、音声から関連する動画を探したりする際に、形式ごとに別の検索基盤を組む必要を減らせる。
構成も固定ではない。270Mのテキスト部分に170Mの視覚、300Mの音声エンコーダーを選択的に加え、270M・440M・570M・740Mから用途に合う規模を選べる。テキストだけなら小さく、すべてを横断したいなら740Mという切り分けだ。これは単に機能が増えたというより、端末の制約に合わせて不要な処理を外せる点が実用的だ。
MLX版はある。ただし導入条件は細かい
MLX Communityの4-bit版は全モダリティを保持し、重みの保存容量は1.098GBだ。MLX自体はApple silicon向けの配列計算フレームワークで、Mac上のローカル実行という方向性は確かに具体化している。
一方、10月7日に確認した使用例は、mlx-vlmの特定Gitリビジョン、MLX 0.32.3以上、Transformers 5.18.0以上を指定する。さらに画像・音声・動画の前処理に必要なEmbeddingGemma2Processorは、通常のPyPI版5.18.0にはまだ含まれないとモデルカードにある。テキストだけならこのプロセッサーは不要だが、投稿にあるuv pip install -U mlx-vlmだけを見て、4種類すべてが通常版で直ちに動くとは考えない方がいい。
「約1GB」はRAM実測と確認できない
投稿は約1GB RAMで動くとするが、公開資料から確認できる1.098GBは重みの保存容量だ。Macの世代、入力、量子化条件をそろえた実行時メモリや速度の測定は示されていない。また4-bit版の公開検証は、少数の合成入力を使った数値スモークテストであり、検索品質を測るMTEBなどのベンチマークではない。用途に応じてBF16版や8-bit版と比べるのが無難だろう。
直接モデルを扱う場合は、テキスト検索で用途別プレフィックスを省くと精度が落ちること、次元を短縮した後は再正規化が必要なことにも注意したい。公式モデルカードはfloat16でNaNや見えにくい品質低下が起こり得るとして、BF16かFP32を推奨している。複数メディアを一つのローカル索引へまとめられるのが今回の面白さで、導入時は対応リビジョンと検索品質を別々に確かめるのが現実的だ。
参考資料
- EmbeddingGemma 2: an open, lightweight multimodal embedding model(Google)
- google/embeddinggemma-2(Hugging Face)
- mlx-community/embeddinggemma-2-4bit(Hugging Face)
- MLX: An array framework for Apple silicon(GitHub)