Editor’s Note
XピックアップBabelArena、同じ買い物でもツール呼び出し8倍 多言語エージェントの盲点
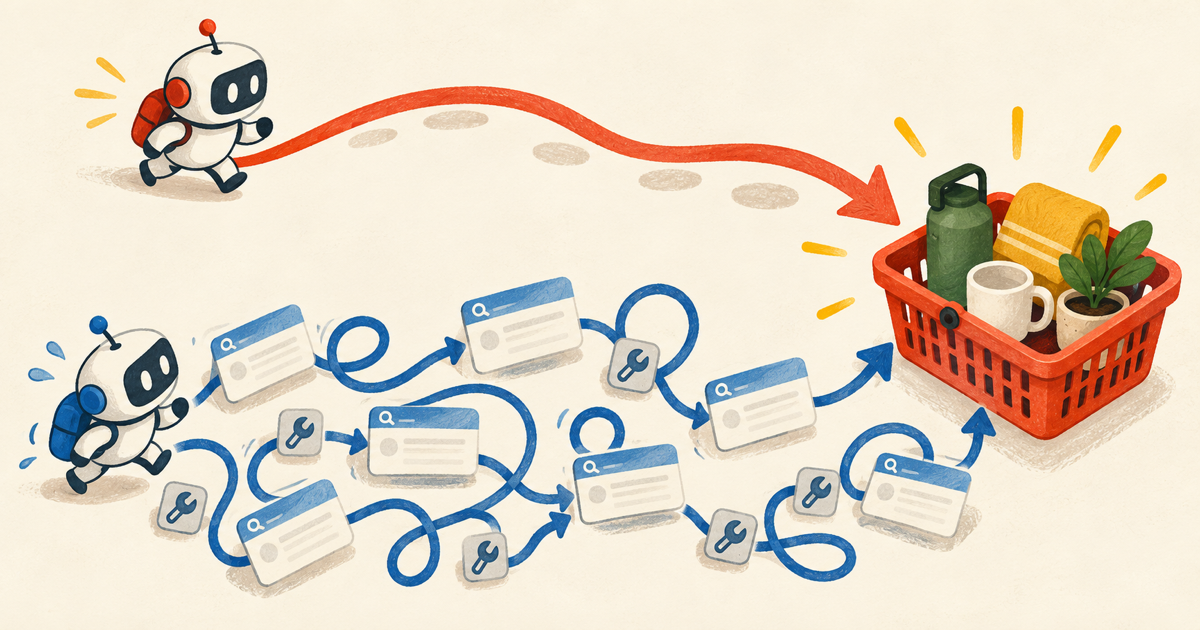
Qwen Developersは10月26日夜、多言語LLMエージェントを評価するオープンソースの「BabelArena」を紹介した。目を引くのは、Qwen-3.8-Maxが英語とテルグ語で同じ4商品を正しく選んだ事例だ。結果だけならどちらも成功だが、ツール呼び出しは英語の25回に対し、テルグ語では201回。約8倍の差は、成功率だけでは本番運用の遅さやコストを見落とすことを示している。
空検索が増えると、成功の中身が変わる
論文によると、この差は一つの印象的な例だけではない。商品購入タスク「DP-Shop」では、評価した5モデルすべてで低リソース言語の検索回数が増えた。検索結果が空だった割合は英語の6.1〜17.1%に対し53.7〜68.7%。英語より増えたツール呼び出しの49.8〜79.9%を、追加の商品検索が占めたという。これは著者らの評価結果であり、本稿で再検証した数字ではない。
同じ品物へたどり着いても、検索語とカタログ表記がかみ合わず何度も空振りすれば、待ち時間とAPI利用量は膨らむ。使う側から見ると、正答率に加えて検索反復、言語の一貫性、ツール呼び出し数を並べられることがBabelArenaの実用的な価値だ。
タスク文だけでなく、道具と環境も23言語へ
従来の多言語評価には、タスク文など一部だけを翻訳するものが多い。BabelArenaはプロンプト、タスク、ツールの説明、環境内の内容を連携して23言語へ適応する。リポジトリと論文では、BabelFlowが実行時の依存関係を追い、共有する商品名などの訳をそろえたうえで、多段階の検証と人手レビューを行うと説明している。
ただし、規模の表記は公式資料内でも一致していない。10月27日時点で、READMEと論文v2の主要表は699タスク・16,077インスタンスだが、arXivの概要と本文の一部には702タスク・16,146インスタンスという旧数値が残る。現状は前者が最新に見えるものの、確定値として片方だけを掲げるのは避けたい。
試すなら、かなり大きな評価実験になる
実行手順はPython 3.12に加えて3.10または3.11、ClawEval用Docker、PyYAML、評価対象モデルとシミュレーター/判定器を動かすOpenAI互換エンドポイント、約14GB以上の保存領域を求める。標準構成は699タスク×23言語×3試行で、気軽なスモークテストという規模ではない。
公開データは固定されたstandardサブセットで、fullサブセットは再現できない。学習へ流用すると以後の評価が意味を失う点にも注意が要る。また翻訳品質は、高リソース7言語を人間の専門家が確認した一方、中・低リソース16言語はGPT-5.6-Solによる評価だ。BabelArenaは多言語エージェントを一つの順位に押し込むより、「成功したが、どこで無駄が増えたか」を調べるための道具として見るのが合っている。