Editor’s Note
XピックアップHermes Index、4つの実作業ベンチでモデル性能と費用を比較
Teknium氏は日本時間10月7日、Hermes Agentで使うモデルを性能と費用の両面から選べる「Hermes Index」を紹介した。単なるおすすめ順位ではない。4種類の実作業ベンチマークを一つの指数にまとめ、1タスク当たりの平均費用も並べた点が新しい。高性能モデルを探す人だけでなく、日常運用の予算を決めたい人にも関係する指標だ。
4つのスイートを、Hermes上で同じ物差しに
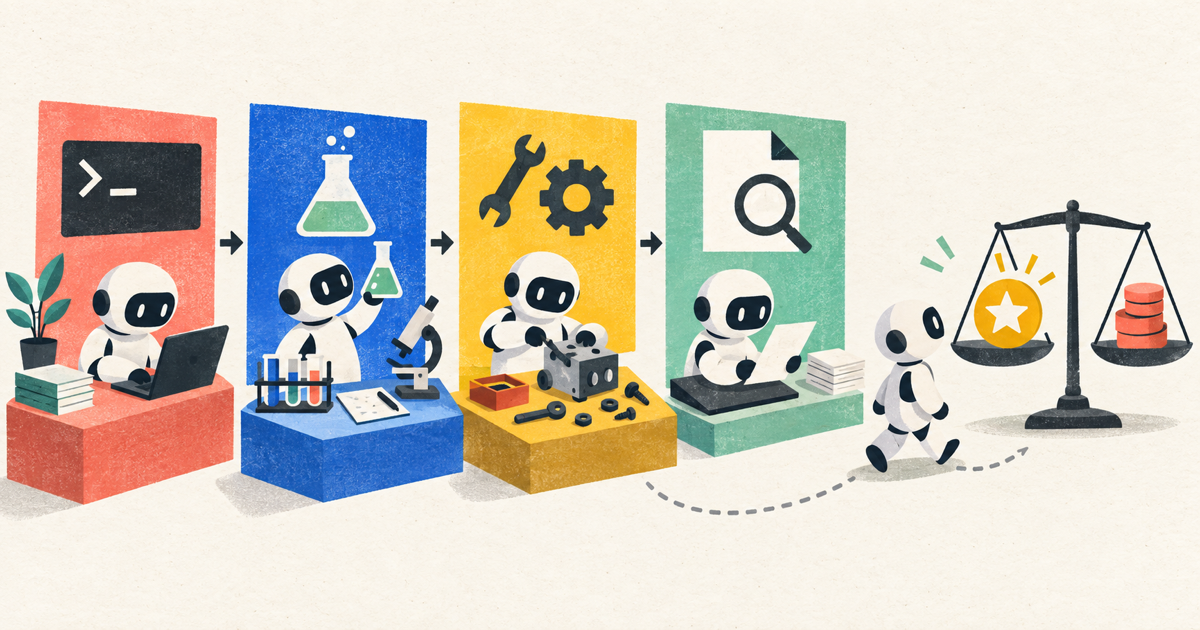
10月7日に確認した公式ランキングは、Hermes Bench、TerminalBench 4、TerminalBench Science、SkillsBenchのスコアを平均し、費用も1タスク単位で示す。すべてHermes Agentの実行基盤上で1回ずつ試すpass@1評価で、対応モデルの推論強度はhighに設定される。つまり基礎モデル単体の万能ランキングではなく、「Hermes Agent内で仕事を任せたとき」の比較だ。
独自のHermes Benchは25カテゴリー・150タスクで構成され、回答文だけでなく、作られたファイルや終了時の状態も採点する。2026年10月7日時点の総合首位はClaude Opus 5.5の63.31、平均費用は1タスク4.99ドル。ただし費用には暫定を示す印が付く。公式ページには、より安い全モデルより高得点のモデルだけを残すパレート最適一覧もあり、首位をそのまま選ぶより、予算の上限から候補を絞る使い方が実際的だ。これらは公開ページの測定値であり、本記事で再実行した結果ではない。
切り替えは簡単だが、会話途中には追加費用も
候補を決めたらHermesの/modelでモデルを切り替えられる。ただしチャット内で選べるのは設定済みのプロバイダーに限られ、新しい接続先はチャット外でhermes modelを実行して追加する必要がある。
もう一つ小さくない注意点がある。会話途中でモデルを替えるとプロンプトキャッシュがリセットされ、次のターンでは会話全体が通常の入力料金で読み直される。ランキングの「1タスク当たり費用」が安くても、長い会話を頻繁に乗り換える運用では、そのままの金額感にならない。
数字の横に、比較条件も置いて見る
現行の比較には留保がある。TerminalBench 4ではGPUを使う4課題を除外。アスタリスク付きの値は部分実行または費用推定で、完全な再実行を待つ暫定値だ。SkillsBenchでは公開リポジトリから解答を見つけた実行があったため、該当課題を除くclean値を正式値としている。
また、SkillsBench原論文のv4は87タスク・8領域を、スキルなしと厳選スキルありの対応条件で比べる設計だ。一方、Hermes Indexはモデルごとの単一列を掲載し、使用コミットや条件を明記していない。原論文の集計値と同じ条件だとは断定できない。Hermes Indexの面白さは、性能と費用を実際のエージェント作業へ寄せて同時に見せたこと。順位表を結論としてではなく、自分の環境で試す候補を減らす入口として使うのがちょうどいい。
参考資料
- Hermes Index | Agentic Model Leaderboard(Nous Research)
- Slash Commands Reference | Hermes Agent(Nous Research)
- SkillsBench: Benchmarking How Well Agent Skills Work Across Diverse Tasks(arXiv)